지니젠AI 한국어 리더보드로 모델 고르는 법: 7개 평가 항목과 등급 분포
오픈라우터 모델 330개를 한국어로만 채점한 허깅페이스 리더보드에서 무엇을 재는지, 등급이 어떻게 나뉘었는지, 후보를 좁히는 순서와 이 순위표가 말해 주지 않는 것을 적었습니다.
AI타임스 9월 17일 기사로 지니젠AI의 한국어 리더보드를 알게 됐고, 9월 27일과 29일에 허깅페이스에서 직접 열어 숫자를 맞춰 봤습니다. 오픈라우터에 올라온 모델 330개를 한국어로만 채점한 순위표인데, 종합 A등급 이상은 25개(7.6%)였고 F등급이 111개(33.6%)였습니다. 영어 순위표에서 위에 있는 모델이라도 한국어 업무에서는 이 F 안에 들어 있을 수 있다는 뜻입니다.
찾을 때는 한글 검색어로 잘 걸리지 않아서 영문 이름 OpenRouter Leaderboard 로 찾거나 주소(huggingface.co/spaces/ginigen-ai/open-router-leaderboard)로 바로 들어가야 나옵니다. 아래는 이 순위표가 무엇을 재는지, 어떤 순서로 보면 되는지, 그리고 여기서 알 수 없는 것을 정리한 내용입니다.
지니젠AI 한국어 리더보드는 무엇을 평가하나
오픈라우터는 여러 회사의 AI 모델을 한 API로 골라 쓸 수 있게 묶어 주는 중개 서비스입니다. 지니젠AI는 여기 올라온 모델을 모아서 응답 속도와 한국어 품질을 따로 재고, 그 결과를 허깅페이스 Space로 공개했습니다.
평가 대상 숫자는 보는 시점마다 조금 다릅니다. AI타임스 기사에는 오픈라우터 모델 426종 중 330종을 평가했다고 나오고, 2026년 10월에 확인한 지니젠AI의 허깅페이스 블로그 글(OpenRouter Leaderboard 소개 글)에는 목록 425개, 한국어 등급 330개, 첫 토큰 응답 속도를 잰 모델 329개로 적혀 있습니다. 순위표가 매일 갱신되니 모델 수도 따라 바뀝니다.
한국어 평가 7개 항목과 각각 재는 것
영어 벤치마크는 보통 추론, 지식, 코딩 같은 범용 능력을 잽니다. 이 리더보드는 한국어로 일을 시킬 때 걸리는 지점을 7개로 나눠 따로 봅니다. 항목 설명은 지니젠AI 블로그 글에 적힌 내용입니다.
| 항목 | 재는 것 |
|---|---|
| 문체 일관성 | 답 하나 안에서 존댓말·반말 수준을 끝까지 유지하는지 |
| 한국 기관 지식 | 노동법, 세목, 공공기관 절차 같은 사실 |
| 지시 준수 | ”두 문장으로만” 같은 형식 지시를 지키는지 |
| 존칭 정확도 | 주체·객체 높임을 맞게 쓰는지 |
| 요약 | 줄일 때 숫자와 고유명사를 그대로 지키는지 |
| 전문 용어 | 금융·법률·공학 용어 |
| 번역투 회피 | 영어를 옮긴 문장이 아니라 한국어로 읽히는지 |
AI타임스 기사는 “자연스러운 문장이라도 존칭이나 연차·세목 안내 등 업무 정확도에서 오답이 빈번했다”고 전합니다. 문장이 매끄러우면 그냥 넘기기 쉬운데, 윗사람에게 보낼 메일의 높임이 어긋나거나 연차 안내가 틀리면 그대로 쓸 수 없습니다. 이런 부분이 영어 순위표에는 드러나지 않습니다.
한국어 등급 분포: A 이상 7.6%, F 33.6%
채점은 항목마다 A, B, C, F 중 하나를 주고, 이걸 평균 내서 A+++부터 F까지 8단계 종합 등급으로 바꾸는 방식입니다. 7개 항목 중 5개 미만만 채점된 모델은 종합 등급 없이 부분 채점으로 표시됩니다. 단계별 점수 경계는 공개 글에 나와 있지 않습니다.
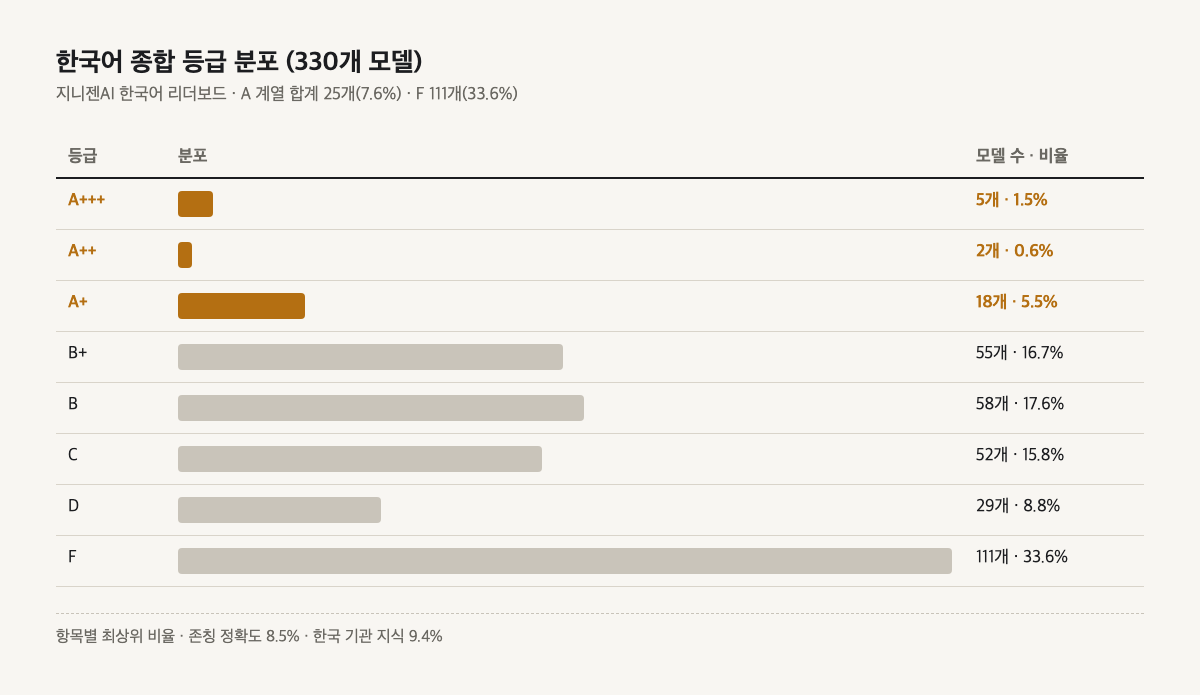
| 종합 등급 | 모델 수 | 비율 |
|---|---|---|
| A+++ | 5 | 1.5% |
| A++ | 2 | 0.6% |
| A+ | 18 | 5.5% |
| B+ | 55 | 16.7% |
| B | 58 | 17.6% |
| C | 52 | 15.8% |
| D | 29 | 8.8% |
| F | 111 | 33.6% |
A 계열 세 단계를 합치면 25개, 7.6%입니다. 단계 하나로는 F가 가장 많아서 평가 대상의 3분의 1이 최하 등급을 받았습니다.
항목별로 좁히면 더 적어집니다. 기사에 따르면 존칭 정확도에서 최상위에 든 모델은 8.5%, 한국 기관 지식에서 최상위에 든 모델은 9.4%로 둘 다 열 개 중 하나가 안 됩니다. 한국어로 고객 응대 문구나 사내 안내문을 쓰게 할 생각이면 종합 등급보다 이 두 항목을 먼저 보는 편이 맞습니다.
리더보드에서 후보 모델 좁히는 순서
- Space 열기. 주소로 들어가거나 허깅페이스에서 영문 “OpenRouter Leaderboard”로 검색합니다. 순위는 매일 오전 8시(한국 시간)에 갱신됩니다.
- 용도 고르기. 용도별 출발점이 있습니다. 코딩 에이전트, 긴 문서, 대량 처리, 실시간, 한국어 업무, 멀티모달 중에서 내 일에 가까운 것을 고르고 필터를 더 겁니다. 화면 언어는 한국어·영어·중국어, 가격 표시는 원·달러·위안 중에서 고를 수 있습니다.
- 2~4개 나란히 비교. 후보를 두 개에서 네 개까지 골라 나란히 놓으면 7개 항목 등급이 펼쳐져 나옵니다.
- 내게 중요한 항목만 보기. 종합 등급이 같아도 항목별로는 다릅니다. 존칭이 중요한 일이면 존칭 정확도와 문체 일관성, 보고서 요약이면 요약과 전문 용어를 봅니다.
- 필터 걸린 화면 링크 저장. 필터를 건 화면을 링크로 공유할 수 있어서, 같이 고르는 사람에게 그대로 넘길 수 있습니다.
데이터를 직접 가공하고 싶으면 공개 API를 씁니다. 키 없이 열려 있고, 블로그 글에 적힌 경로는 /api/korean(한국어 등급), /api/speed(응답 속도), /api/models(모델 목록) 세 개입니다.
한국어 리더보드 순위표가 말해 주지 않는 것
이 리더보드를 그대로 정답으로 쓰기 어려운 이유가 몇 가지 있습니다.
- 평가 기준을 만든 곳이 한 회사입니다. 지니젠AI도 블로그 글에서 7개 항목을 “표준이 아니라 제안”이라고 적었습니다. 등급에 이의가 있으면 프롬프트와 함께 피드백을 보낼 수 있게 해 두었습니다.
- 순위가 매일 바뀝니다. 오늘 본 등급이 다음 주에도 같다는 보장이 없습니다. 고른 날짜를 같이 적어 두는 편이 낫습니다.
- 속도 수치는 한 번 잰 값입니다. 정해 둔 프롬프트로 특정 시점에 한 번 호출해 잰 값이라, 오픈라우터가 실제 트래픽으로 보여 주는 지연 분포와는 따로 표시됩니다.
- 벤치마크 오염 문제가 있습니다. 평가 문제가 모델 학습 데이터에 섞이면 점수가 실제보다 높게 나옵니다. 그래서 순위표만 보지 말고 실제로 시킬 일 두세 개를 직접 돌려 비교하라는 의견이 있습니다.
순위표로는 후보를 서너 개까지 줄이고, 그다음에는 내 업무 문장 몇 개를 직접 넣어 보는 편이 확실합니다. 높임이 들어간 메일 초안이나 숫자가 많은 문서 요약처럼 실제로 시킬 일을 넣어 보면, 항목별 등급 차이가 내 일에서도 나는지 바로 보입니다. 다운로드 수만 보고 모델을 고를 때 생기는 문제는 허깅페이스 오픈소스 모델 고르는 법에, AI가 낸 결과를 다시 세어 봤던 일은 AI가 조사해 준 50곳을 다시 세어 본 글에 적어 두었습니다.
자주 묻는 질문
영어 벤치마크 순위가 높으면 한국어도 잘하나요?
꼭 그렇지는 않습니다. 지니젠AI가 오픈라우터 모델을 한국어로 평가한 결과를 보면, 문장이 자연스러워도 존칭이나 연차·세목 안내 같은 업무 정확도에서 오답이 빈번했습니다. 출시 시점이나 영어권 벤치마크만으로는 한국어 능력을 판단하기 어렵습니다.
이 리더보드는 어디서 보나요?
허깅페이스의 Space에서 볼 수 있습니다. 주소는 huggingface.co/spaces/ginigen-ai/open-router-leaderboard이고, Space 이름은 영문 "OpenRouter Leaderboard"입니다. 허깅페이스 검색은 영문 이름으로 하는 편이 찾기 쉽습니다.
리더보드 순위만 믿고 모델을 골라도 되나요?
참고용으로 쓰되 마지막은 직접 돌려보는 편이 안전합니다. 평가 문제가 학습 데이터에 섞이면 점수가 실제보다 높게 나오는 벤치마크 오염 문제가 있다는 의견이 있습니다. 실제로 시킬 일 두세 개를 직접 비교해 보는 것을 권합니다.