허깅페이스 오픈소스 모델 고르는 법: 다운로드 수 대신 공개 범위와 손상도 확인
허깅페이스 다운로드 수가 실제로 무엇을 세는지, 그리고 원본 모델은 공개 범위로, 파생 튜닝 모델은 KL과 손댄 텐서 수로 거르는 순서를 적었습니다.
로컬에서 돌릴 오픈소스 모델을 고르려고 허깅페이스에서 다운로드 순으로 정렬해 보다가, 자료 두 개를 읽고 기준을 바꿨습니다. 하나는 Gemma 4 파생 모델 23개를 원본과 하나씩 비교한 벤치마크였는데, 다운로드가 80만 회 근처로 가장 많던 모델이 가장 많이 망가져 있었습니다. 다른 하나는 가중치뿐 아니라 학습 코드와 로그까지 같이 공개한 국내 모델이었습니다.
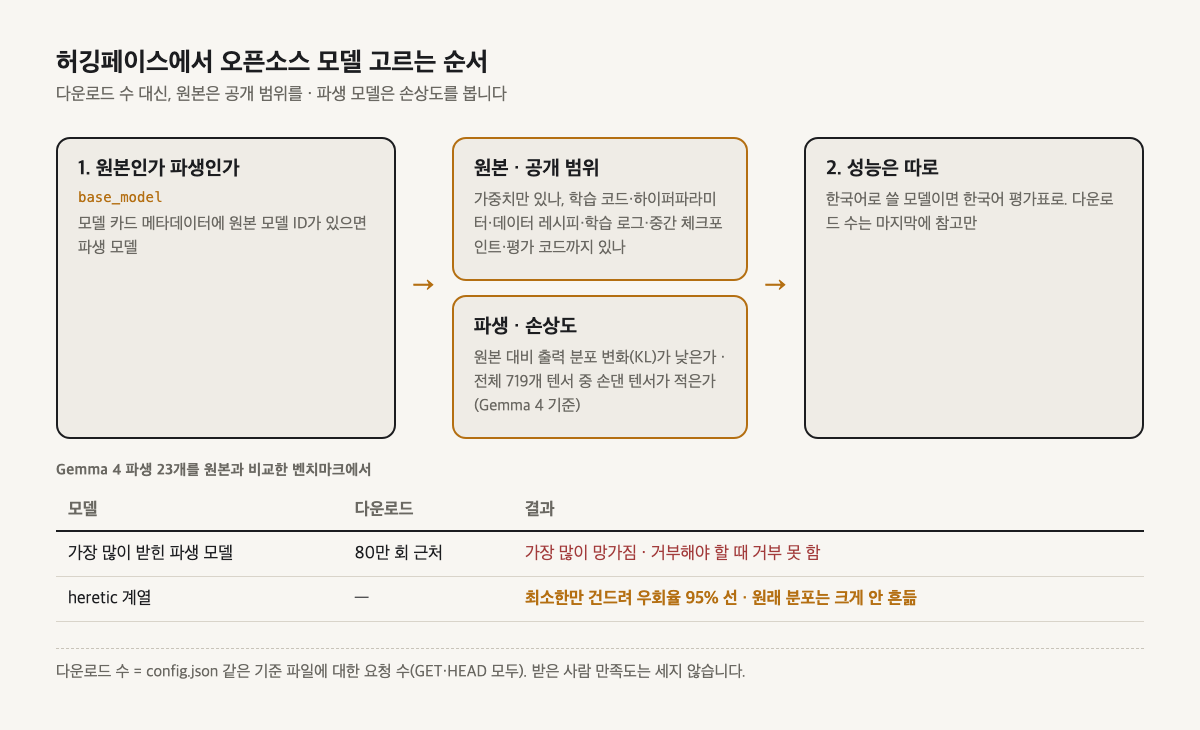
그 뒤로는 다운로드 수보다 두 가지를 먼저 봅니다. 원본 모델이면 공개 범위(만드는 법까지 열려 있는지), 누가 튜닝해서 올린 파생 모델이면 손상도(원래 역량을 얼마나 지켰는지)입니다.
허깅페이스 다운로드 수는 무엇을 세나
허깅페이스 공식 문서(Models Download Stats)를 보면 다운로드 수는 서버가 특정 파일을 내줄 때 셉니다. 라이브러리를 따로 정하지 않은 저장소는 config.json 같은 설정 파일이 기준이고, 이 파일에 대한 HTTP 요청은 GET 이든 HEAD 든 전부 다운로드 한 번으로 셉니다. GGUF 파일은 파일마다 셉니다.
같은 문서에서 CI/CD 파이프라인이 받은 것을 빼거나 받은 사람을 중복 없이 세려면 별도의 Publisher Analytics 로그가 필요하다고 안내합니다. 모델 페이지에 보이는 숫자는 그런 구분 없이 센 값입니다. 많이 받혔다는 건 그만큼 노출됐고 여러 곳에서 불러갔다는 뜻이지, 받아 본 사람이 만족했다는 뜻은 아닙니다.
원본 모델은 공개 범위부터 확인
오픈소스라고 올라오는 모델 상당수는 완성된 가중치 파일만 줍니다. 결과물은 손에 들어오지만 어떤 데이터로 어떻게 학습했는지는 알 수 없습니다. 문제가 생겨도 원인을 따라갈 방법이 없고, 재현이나 검증은 만든 쪽 설명을 믿는 수밖에 없습니다.
반대 사례가 국내 기업 비드래프트가 공개한 모델입니다. 학습 데이터 레시피, 전체 학습 코드, 하이퍼파라미터, 학습 로그, 중간 체크포인트, 평가 코드까지 같이 열었습니다. 허깅페이스에서 받을 수 있고 라이선스는 아파치 2.0이라 상업적으로도 쓸 수 있습니다. 다만 공개 당시 성능 벤치마크 수치는 붙어 있지 않아서, 이 모델을 고른다면 이유는 성능이 아니라 공개 방식입니다.
| 확인할 것 | 가중치만 공개 | 완전 공개형 |
|---|---|---|
| 가중치 파일 | 있음 | 있음 |
| 학습 코드·하이퍼파라미터 | 없음 | 있음 |
| 데이터 레시피·학습 로그 | 없음 | 있음 |
| 중간 체크포인트·평가 코드 | 없음 | 있음 |
허깅페이스에서는 이렇게 확인합니다.
- 모델 카드(저장소의
README.md) 위쪽 라이선스 표시를 봅니다. 라이선스는 모델 카드 메타데이터의license필드로 표시되고, 모델 목록에서 라이선스로 거를 수도 있습니다. - 저장소 파일 목록에 가중치 말고 학습 스크립트나 설정 파일이 있는지 봅니다.
- 모델 카드에 학습 데이터, 학습 로그, 평가 코드 링크가 있는지 봅니다. 메타데이터에
datasets를 넣은 모델은 학습에 쓴 데이터셋이 페이지에 연결되어 나옵니다(Model Cards 문서).
학습 코드와 로그가 있으면 나중에 이상한 답이 나왔을 때 안을 열어 볼 수 있습니다. 혼자 운영하면 그 디버깅도 내가 해야 하니, 이 차이가 생각보다 큽니다.
파생 튜닝 모델은 손상도를 확인
파생 모델은 누군가 원본(base) 모델을 가져와 튜닝해서 올린 것입니다. 다운로드 수가 특히 믿기 어려운 곳이 여기입니다.
먼저 원본이 무엇인지 찾습니다. 모델 카드 메타데이터의 base_model 필드에 원본 모델 ID가 들어가고, 허깅페이스는 이 값으로 원본 모델을 페이지에 표시하고 같은 원본에서 나온 모델을 모아 볼 수 있게 해 줍니다. 튜닝인지, 어댑터(LoRA 등)인지, 양자화인지, 여러 모델을 합친 것인지도 이 관계로 구분합니다.
원본을 찾았으면 두 숫자를 봅니다.
- 원본 대비 출력 분포 변화(KL) 가 낮을수록 원래 역량을 더 지킨 것입니다.
- 손댄 텐서 수 가 적을수록 부작용이 작습니다. Gemma 4 기준으로 전체 텐서는 719개입니다.
앞의 Gemma 4 파생 23개 비교에서 다운로드가 80만 회 근처였던 모델은 검열을 지우는 과정에서 너무 넓게 손을 대, 거부해야 할 상황에서도 거부를 못 하게 됐습니다. 같은 검열 우회라도 heretic 계열은 최소한의 부분만 건드리는 방식으로 우회율 95% 선을 내면서 원래 분포는 크게 흔들지 않았습니다. 목적은 같아도 얼마나 넓게 손을 댔는지에 따라 원래 역량이 남는 정도가 달랐는데, 다운로드 수에는 이 차이가 드러나지 않습니다.
모델 고르는 순서
- 받을 모델이 원본인지 파생인지 모델 카드의
base_model표시로 가립니다. - 원본이면 라이선스와 함께 학습 코드·로그·데이터 레시피가 공개됐는지 봅니다.
- 파생이면 원본 대비 KL과 손댄 텐서 수를 비교한 자료가 있는지 찾습니다.
- 성능은 따로 확인합니다. 한국어로 쓸 모델이면 한국어 평가표를 봅니다. 한국어 순위표 읽는 법은 한국어 AI 품질 리더보드 보는 법에 따로 적었습니다.
- 다운로드 수는 마지막에 많이 쓰이는 모델인지 정도로만 참고합니다.
이 기준으로 알 수 없는 것
- 성능 · 공개 범위가 넓다고 성능이 좋은 건 아닙니다. 비드래프트 모델도 공개 당시엔 벤치마크 수치가 없었습니다.
- KL·텐서 수가 없는 모델 · 대부분의 파생 모델 카드에는 이 숫자가 없습니다. 23개를 한꺼번에 비교한 벤치마크처럼 누군가 따로 재 둔 자료가 있을 때만 쓸 수 있습니다.
- 내 용도에 맞는지 · 검열 우회처럼 목적이 분명한 튜닝은 그 목적에서는 쓸 만해도 다른 용도에서는 원본보다 못할 수 있습니다. 후보 몇 개를 내 작업으로 직접 돌려 보는 단계는 그대로 남습니다.
자주 묻는 질문
오픈소스 모델의 다운로드 수를 신뢰해도 되나요?
다운로드 수는 품질이 아니라 홍보 노출을 따라갑니다. 실제로 파생 튜닝 모델 비교에서 가장 많이 받힌 모델이 가장 크게 망가져 있던 사례가 있었습니다. 받은 횟수는 최소한 단독 선택 기준이 되지 못합니다.
완전 공개형 모델인지 어떻게 가려내나요?
가중치 파일 하나만 있는지, 아니면 학습 코드와 학습 로그가 함께 있는지를 봅니다. 데이터 레시피, 하이퍼파라미터, 중간 체크포인트, 평가 코드까지 열려 있으면 재현과 검증이 가능한 완전 공개형에 가깝습니다.
파생 튜닝 모델이 원래 역량을 얼마나 지켰는지 어떻게 보나요?
base 대비 출력 분포 변화(KL)가 낮을수록, 그리고 전체 텐서 중 손댄 텐서가 적을수록 원래 역량을 더 지킵니다. 검열 제거 같은 튜닝이 광범위하게 텐서를 건드리면 거부 능력 자체를 잃는 등 부작용이 생길 수 있습니다.