노션 API 자동화를 속성 ID로 짜서 컬럼 이름 변경에 안 깨지게 하기
노션 데이터베이스에 자동으로 기록하는 코드가 컬럼 이름 하나 바꿨다고 멈출 때, 원인과 속성 ID 매핑으로 고치는 코드, 그래도 남는 한계와 API 버전 변경까지 다룹니다.
수집 결과와 작업 로그를 노션 데이터베이스에 자동으로 쌓는 코드를 6월에 붙여 두었는데, 노션 화면에서 컬럼 이름만 바꿔도 그 코드가 바로 실패했습니다. 코드가 컬럼을 이름으로 찾고 있었기 때문입니다. 노션은 컬럼마다 이름과 따로 속성 ID를 가지고 있고 이름을 바꿔도 ID는 그대로라서, 실행할 때 스키마를 한 번 조회해 이름과 ID를 짝지어 두고 ID로 쓰게 바꾸면 컬럼을 옮기거나 이름을 바꿔도 코드를 고치지 않아도 됩니다.
아래는 그렇게 바꾼 순서와 코드, 바꾼 뒤에도 남는 한계, 그리고 노션 API 버전이 바뀌면서 새로 생긴 함정까지입니다.
노션 컬럼 이름을 바꾸면 API 쓰기가 실패하는 이유
노션을 기록 저장소로 쓰고 거기에 행을 자동으로 쌓는 구성은 혼자 일할 때 흔합니다. 이 구성은 한동안 문제없이 돌다가 컬럼 이름을 손보는 순간 멈추고, 코드는 그대로인데 실패하니 처음에는 API 쪽 문제를 먼저 의심하게 됩니다.
흔한 코드는 이런 모양입니다.
# 흔한 형태 — 이름 문자열이 코드에 박혀 있다
properties = {
    "제목": {"title": [{"text": {"content": title}}]},
    "상태": {"select": {"name": "대기"}},
    "수집일": {"date": {"start": collected_at}},
}
노션 화면에서 수집일을 수집 날짜로 바꾸면 이 코드는 없는 속성에 값을 넣으려 하고, API는 오류를 돌려줍니다. 노션 공식 문서는 요청 본문이 스키마와 맞지 않을 때 400 validation_error를 돌려준다고 적고 있고, 응답의 message에 이유가 같이 옵니다. 컬럼을 옮기거나 하나 끼워 넣기만 해도, 순서를 가정한 코드는 같은 이유로 깨집니다.
노션 속성 ID 확인하는 법
답은 API 응답 안에 이미 들어 있습니다. 데이터베이스를 조회하면 속성마다 id가 같이 내려옵니다.
curl -s -X GET "https://api.notion.com/v1/databases/$DATABASE_ID" \
  -H "Authorization: Bearer $NOTION_TOKEN" \
  -H "Notion-Version: 2022-06-28" | jq '.properties | to_entries[] | {name: .key, id: .value.id, type: .value.type}'
응답은 대략 이렇게 나옵니다.
{"name": "제목",   "id": "title",  "type": "title"}
{"name": "상태",   "id": "%3AVuS", "type": "select"}
{"name": "수집일", "id": "N%3E%40l", "type": "date"}
%3AVuS 같은 값이 속성 ID입니다. 읽기 좋은 값은 아니지만 노션 문서에도 속성 이름이 바뀌어도 id는 그대로라고 적혀 있습니다. 이름은 화면에 보여 주는 라벨이고 실제 식별자는 따로 있는 구조라서, 이름으로 접근하는 코드는 라벨을 식별자처럼 쓰고 있던 셈입니다.
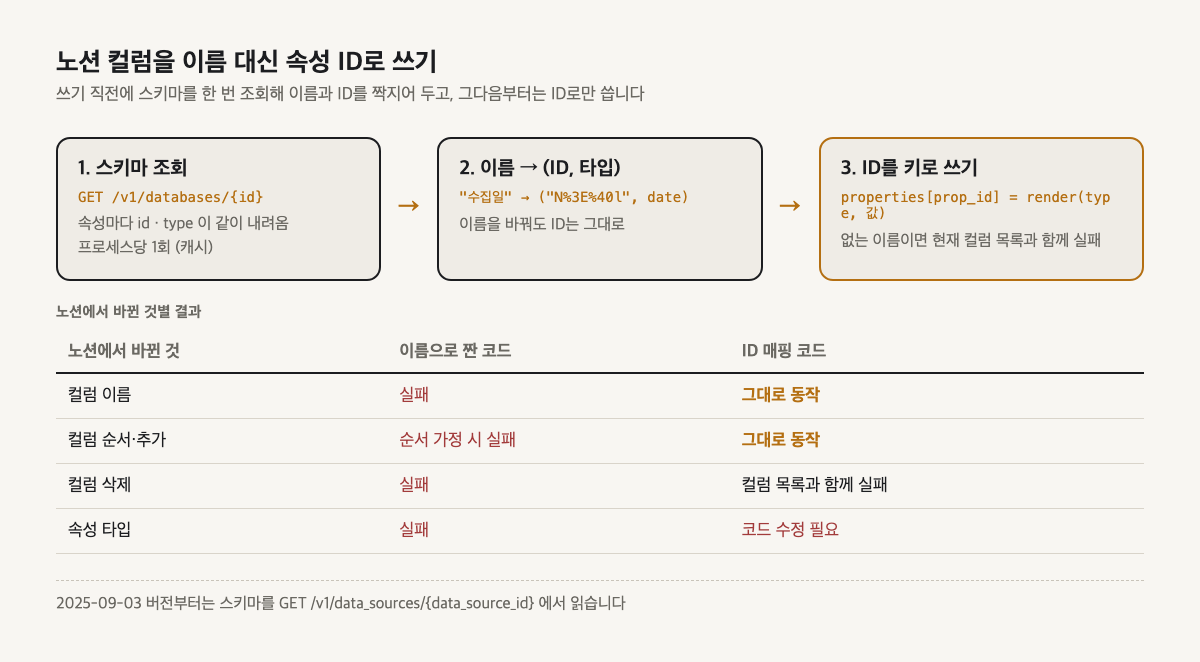
실행 시점에 스키마를 조회해 이름-ID 매핑 만들기
ID를 코드에 하드코딩하는 건 답이 아닙니다. 그러면 이번에는 데이터베이스를 복제하거나 다른 워크스페이스로 옮길 때 깨집니다. 대신 쓰기 직전에 스키마를 한 번 조회해서, 그 자리에서 이름과 ID를 짝지어 둡니다.
import os, requests
from functools import lru_cache

NOTION_TOKEN = os.environ["NOTION_TOKEN"]
HEADERS = {
    "Authorization": f"Bearer {NOTION_TOKEN}",
    "Notion-Version": "2022-06-28",
    "Content-Type": "application/json",
}


@lru_cache(maxsize=8)
def load_schema(database_id: str) -> dict:
    """이름 -> (속성 ID, 타입) 매핑을 만든다. 프로세스당 1회만 조회된다."""
    r = requests.get(
        f"https://api.notion.com/v1/databases/{database_id}",
        headers=HEADERS,
        timeout=10,
    )
    r.raise_for_status()
    props = r.json()["properties"]
    return {name: (p["id"], p["type"]) for name, p in props.items()}
쓸 때는 이름 대신 ID를 키로 넣습니다. 노션 API는 properties 키 자리에 이름과 ID를 둘 다 받아 주는데, ID로 쓰면 이름이 바뀌어도 영향을 받지 않습니다.
def build_properties(database_id: str, values: dict) -> dict:
    """values = {"제목": ..., "상태": ..., "수집일": ...}"""
    schema = load_schema(database_id)
    out = {}
    for name, value in values.items():
        if name not in schema:
            raise KeyError(f"노션에 '{name}' 컬럼이 없습니다. 현재 컬럼: {list(schema)}")
        prop_id, prop_type = schema[name]
        out[prop_id] = render(prop_type, value)
    return out


def render(prop_type: str, value):
    if prop_type == "title":
        return {"title": [{"text": {"content": str(value)}}]}
    if prop_type == "rich_text":
        return {"rich_text": [{"text": {"content": str(value)}}]}
    if prop_type == "select":
        return {"select": {"name": str(value)}}
    if prop_type == "date":
        return {"date": {"start": value}}
    if prop_type == "number":
        return {"number": value}
    if prop_type == "checkbox":
        return {"checkbox": bool(value)}
    raise ValueError(f"아직 다루지 않는 타입: {prop_type}")
이렇게 하면 두 가지가 같이 풀립니다. 이름이 바뀌어도 ID로 쓰니까 코드를 고칠 일이 없고, render가 타입을 스키마에서 읽어 값의 모양을 정하니까 어느 컬럼이 셀렉트이고 어느 컬럼이 날짜인지 코드가 따로 기억하고 있지 않아도 됩니다.
render에 텍스트를 넣을 때 하나 더 볼 것이 있습니다. 노션 API는 rich text 한 조각의 content를 2,000자까지만 받습니다(2026년 10월 확인). 긴 요약문을 한 칸에 넣는 자동화라면 2,000자 단위로 잘라 여러 조각으로 넣어야 합니다.
컬럼을 못 찾으면 현재 컬럼 목록과 함께 실패시키기
위 코드에서 일부러 KeyError를 던지고 지금 있는 컬럼 목록을 같이 붙였습니다. 누가 컬럼을 지웠거나 코드에 오타가 있을 때, 어떤 이름을 찾다가 실패했고 지금은 어떤 컬럼이 있는지가 오류 한 줄에 다 나옵니다.
자동화는 조용히 넘어가면 며칠 뒤에야 발견됩니다. 자동으로 맡겨 둔 블로그 발행이 닷새 동안 멈춰 있던 걸 주간 회고에서야 안 적이 있는데, 그때 찾은 방법은 만료된 토큰이 닷새를 먹은 이야기에, 실패를 어디서 시끄럽게 만들지에 대한 기준은 조용한 실패가 제일 비싸다에 적어 두었습니다.
스키마 조회 비용과 노션 API 요청 한도
쓰기 앞에 조회가 한 번 늘어납니다. 한 건씩 쓰면 왕복이 한 번 더 들고, 여러 건을 한 번에 쓰면 lru_cache 덕분에 프로세스당 한 번입니다.
노션 API 요청 한도는 연결 하나당 분당 180회, 평균 초당 3회입니다(Business·Enterprise 요금제는 분당 600회, 2026년 10월 확인). 넘으면 429 rate_limited가 오고, 응답의 Retry-After 헤더만큼 기다렸다가 다시 보내면 됩니다. 쓰기마다 스키마를 새로 조회하면 이 한도의 절반을 조회에 쓰게 되니, 캐시는 속도보다 한도 때문에 필요합니다.
하루 종일 떠 있는 워커라면 반대로 캐시를 영원히 들고 있는 게 문제가 됩니다. 새벽에 읽은 스키마를 저녁까지 쥐고 있으면 낮에 추가한 컬럼이 반영되지 않습니다. 이럴 때는 TTL을 둡니다.
import time

_cache: dict[str, tuple[float, dict]] = {}
TTL_SECONDS = 600


def load_schema_ttl(database_id: str) -> dict:
    now = time.time()
    hit = _cache.get(database_id)
    if hit and now - hit[0] < TTL_SECONDS:
        return hit[1]
    schema = _fetch_schema(database_id)   # 위 load_schema 의 캐시 없는 버전
    _cache[database_id] = (now, schema)
    return schema
속성 ID로 바꿔도 깨지는 경우
무엇이 바뀌었느냐에 따라 결과가 다릅니다.
| 노션에서 바뀐 것 | 이름으로 짠 코드 | ID 매핑 코드 |
|---|---|---|
| 컬럼 이름 | 실패 | 그대로 동작 |
| 컬럼 순서·추가 | 순서 가정 시 실패 | 그대로 동작 |
| 컬럼 삭제 | 실패 | 컬럼 목록과 함께 실패 |
| 속성 타입 | 실패 | 코드 수정 필요 |
속성 타입을 바꾸면 고쳐야 합니다. 텍스트였던 컬럼을 셀렉트로 바꾸면 값의 형태가 달라지고, render가 모르는 타입이면 예외가 납니다. 값의 의미가 바뀐 것이라 코드가 알아서 맞춰 주면 오히려 엉뚱한 데이터가 들어갑니다.
이름은 정리하다가, 용어를 통일하다가, 한글을 영문으로 바꾸다가 자주 손이 가는데, 타입은 한 번 정하면 잘 안 바뀝니다. 그래서 이름이 바뀌는 건 코드가 따라가게 두고, 타입이 바뀌면 그때 코드를 고칩니다.
노션 API 2025-09-03 버전에서 스키마 조회 위치가 바뀐 점
위 코드는 Notion-Version: 2022-06-28 기준입니다. 노션은 2025-09-03 버전부터 데이터베이스 아래에 데이터 소스를 두는 구조로 바꿨고, 스키마(properties)도 데이터 소스로 옮겼습니다(2026년 10월 확인).
- 새 버전에서는
GET /v1/databases/{id}가 속성 대신data_sources목록을 돌려줍니다. 스키마는GET /v1/data_sources/{data_source_id}의properties에서 읽습니다. 각 속성에id·name·type이 들어 있는 건 같습니다. - 데이터 소스 ID는 데이터베이스 조회 결과의
data_sources배열에서 얻거나, 노션 화면의 데이터베이스 설정에 있는 데이터 소스 관리(Manage data sources) 메뉴에서 복사할 수 있습니다. - 옛 버전을 그대로 쓰는 연동은 누군가 그 데이터베이스에 데이터 소스를 하나 더 추가하면 페이지 생성과 데이터베이스 조회·쓰기가 실패합니다. 컬럼 이름을 안 건드렸는데 갑자기 깨졌다면 이쪽을 먼저 봅니다.
버전을 올릴 때는 load_schema의 조회 주소를 데이터 소스 쪽으로 바꾸고, 이름과 ID를 짝짓는 나머지 구조는 그대로 씁니다.
노션 자동화가 멈췄을 때 확인 순서
- 오류 응답의 상태 코드와
message를 봅니다.400 validation_error면 보내는 속성이 스키마와 안 맞는 것이고,401 unauthorized면 토큰 문제입니다.404 object_not_found는 토큰 기준으로 그 데이터베이스가 안 보인다는 뜻이라, 데이터베이스가 연동에 공유되어 있는지부터 확인합니다. - 위
curl명령으로 지금 스키마를 뽑아 코드가 쓰는 이름과 비교합니다. - 이름은 같은데 실패하면 타입이 바뀌었는지 봅니다.
- 컬럼을 건드린 적이 없는데 실패하면 데이터베이스에 데이터 소스가 추가됐는지, 코드의
Notion-Version이 무엇인지 봅니다. 429가 섞여 있으면 스키마 조회가 캐시되고 있는지 확인합니다.
공식 문서는 속성 값 쓰기, 요청 한도, 오류 코드, 2025-09-03 업그레이드 안내에 있습니다.
자주 묻는 질문
노션 API에서 컬럼 이름을 바꾸면 왜 코드가 실패하나요?
코드가 컬럼을 이름 문자열로 찾고 있기 때문입니다. 노션은 속성마다 이름과 별개로 고유한 속성 ID를 가지고 있고, 이름은 사람이 보라고 붙은 라벨입니다. 이름을 바꿔도 ID는 그대로이므로, ID로 접근하면 개명·이동에 영향을 받지 않습니다.
속성 ID는 어디서 확인하나요?
Retrieve a database 엔드포인트를 호출하면 properties 객체가 내려오고, 각 속성마다 id 필드가 들어 있습니다. 별도로 관리자 화면에서 찾을 필요 없이 실행 시점에 한 번 조회해서 이름과 ID를 짝지어 두면 됩니다.
실행할 때마다 스키마를 조회하면 느려지지 않나요?
쓰기 작업 앞에 조회 한 번이 추가됩니다. 배치로 여러 건을 쓸 때는 프로세스당 한 번만 조회해 캐시하면 비용은 사실상 사라집니다. 장시간 도는 워커라면 TTL을 두고 주기적으로 새로 고치는 편이 안전합니다.
속성 ID로 짜면 이제 안 깨지나요?
이름 변경과 순서 변경에는 안 깨집니다. 다만 속성 타입을 바꾸면(예: 텍스트를 셀렉트로) 값의 형태 자체가 달라지므로 코드를 고쳐야 합니다. 실무에서는 이름이 자주 바뀌고 타입은 잘 안 바뀌기 때문에, 자주 바뀌는 쪽을 막는 셈입니다.