LLM 작업 병렬화 전에 호출당 고정비 재기: 68초를 찾고 6분을 2분 53초로
CLI로 부르는 LLM 작업을 잘게 쪼개 병렬로 돌려도 덜 빨라지는 이유와, 호출 시간을 고정비와 생성 시간으로 나눠 재는 순서를 다룹니다. 쪼개는 방향을 뒤집어 52%를 줄인 실제 수치를 함께 적었습니다.
영상 렌더 파이프라인에서 LLM이 화면 위 시각요소 위치를 잡는 단계가 6분 4초 걸렸습니다. 잘게 쪼개 병렬로 돌렸더니 4분 29초까지만 줄었고, 호출 시간을 재 보니 호출 1회마다 고정비가 약 68초, 실제 생성은 구간당 약 1.9초였습니다. 쪼갤수록 68초를 더 내고 있었던 겁니다. 청크 수를 동시 실행 수에 맞춰 한 번에 보내도록 바꾸고 나서 2분 53초가 됐습니다. 처음보다 52% 짧습니다.
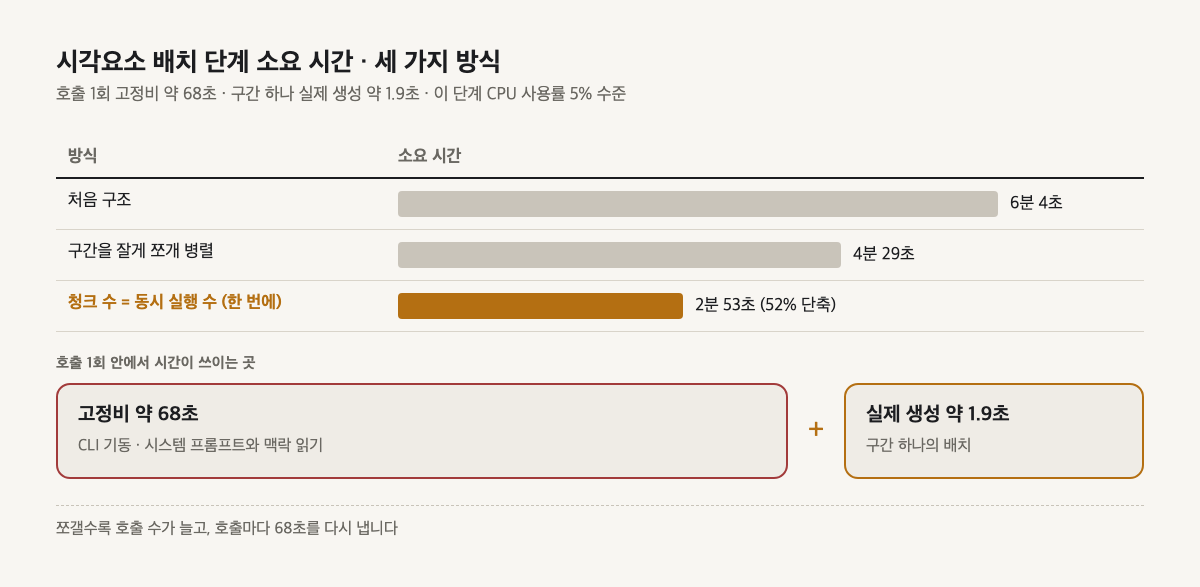
어떤 단계였나: LLM으로 자막·강조 박스 위치 정하기
이 파이프라인은 브라우저로 화면을 그려 영상으로 뽑는 구조입니다. 렌더 자체를 빠르게 만든 과정은 영상 렌더 병목이 인코딩이 아니었던 기록에 따로 적었습니다.
그 앞에 LLM이 자막, 강조 박스, 캡션 같은 시각요소를 화면 어디에 놓을지 정하는 단계가 있는데, 전체 렌더에서 이 단계가 6분 4초로 가장 길었습니다. LLM은 CLI로 불러 쓰고 있었습니다.
처음 한 일: 구간을 잘게 쪼개 병렬로 돌리기
먼저 떠올린 방법은 영상을 여러 구간으로 나누고, 구간마다 배치를 따로 계산하고, 그걸 동시에 돌리는 것이었습니다. 한 번에 처리할 양이 줄고 동시에 돌리니 걸리는 시간도 줄 거라고 봤습니다.
결과는 4분 29초였습니다. 줄기는 했지만 여러 구간을 동시에 돌린 것치고는 너무 적게 줄어서, 계산과 맞지 않았습니다.
LLM 호출 시간을 고정비와 생성 시간으로 나눠 재는 법
더 쪼개 보기 전에 호출 하나가 어디에 시간을 쓰는지부터 쟀습니다. 순서는 이렇습니다.
- 호출 직전과 직후에 타임스탬프를 찍어 호출 한 번의 총 소요를 잽니다.
- 그 안에서 실제 생성에 걸린 시간을 따로 뽑습니다.
- 총 소요에서 생성 시간을 뺀 나머지가 호출마다 붙는 고정비입니다.
제 경우 고정비가 호출당 약 68초였습니다. CLI를 띄우고 시스템 프롬프트와 맥락을 읽어 들이는 데 드는 시간입니다. 구간 하나의 배치를 실제로 만드는 데는 약 1.9초가 걸렸습니다. 68초를 내고 1.9초짜리 일을 시키고 있었습니다.
이걸 알고 나니 4분 29초가 설명됐습니다. 구간을 잘게 쪼갤수록 호출 수가 늘고, 호출이 늘어난 만큼 68초를 더 냈습니다. 병렬로 돌린 덕에 늘어난 몫이 어느 정도 가려졌을 뿐이고, 그래서 어중간하게 줄어든 숫자가 나왔습니다.
쪼개는 방향 바꾸기: 청크 수를 동시 실행 수에 맞추기
고정비가 이만큼 크면 호출 수를 늘리는 선택은 전부 손해입니다. 그래서 구간을 잘게 나눠 호출을 늘리던 걸 그만두고, 청크 수를 동시 실행 수에 맞췄습니다. 나눈 조각을 한 번에 다 동시에 보내고, 여러 차례 나눠 보내지 않는 구조입니다.
이렇게 할 수 있었던 건 이 단계의 CPU 사용률이 5% 수준이었기 때문입니다. 무거운 연산은 LLM 쪽에서 일어나고 서버는 호출을 보내고 기다리기만 해서, 여러 개를 동시에 띄워도 서버 부하가 거의 없었습니다.
바꾼 뒤 2분 53초가 나왔습니다. 6분 4초에서 52% 줄었고, 잘게 쪼갠 병렬보다도 1분 36초 빨랐습니다. 구간을 잘게 관리하던 코드가 빠져서 코드도 더 단순해졌습니다.
병렬화가 효과 있는 경우와 없는 경우
| 상황 | 쪼개서 병렬 | 먼저 할 일 |
|---|---|---|
| 작업 하나의 처리 시간이 김 | 효과 있음 | 동시 실행 수 정하기 |
| 호출마다 고정비가 처리 시간보다 큼 | 쪼갤수록 손해 | 호출 수 줄이기 |
| 어느 쪽인지 모름 | 판단 불가 | 호출 한 번을 재기 |
처리 시간이 긴 일은 여러 갈래로 나눠 동시에 흘려보내면 시간이 줄어듭니다. 작업 하나에 붙는 고정비가 처리 시간보다 크면 반대가 됩니다. 조각이 늘어날 때마다 고정비가 한 번씩 더 붙고, 병렬화는 그걸 가려 줄 뿐 없애 주지는 않습니다.
따라 하기 전에 확인할 것
- 서버 부하 · 제 경우 CPU 5% 수준이라 동시에 여러 개를 띄울 수 있었습니다. LLM을 같은 컴퓨터에서 직접 돌린다면 동시 실행이 곧 그 컴퓨터의 부하가 되니, 같은 방법을 그대로 쓰기 어렵습니다.
- 동시 호출 한도 · 쓰는 LLM 서비스나 요금제에 동시 요청 수·분당 요청 수 제한이 있으면, 동시 실행 수는 그 한도 안에서 정해야 합니다. 한도는 서비스마다 다르고 자주 바뀌니 공식 문서에서 확인합니다.
- 프로세스 메모리 · 호출마다 CLI 프로세스가 하나씩 뜨는 구조라면 동시 실행 수만큼 메모리를 씁니다. 동시에 여러 개를 띄우기 전에 한 개가 얼마나 쓰는지 봐 둡니다.
- 고정비를 줄이는 다른 길 · 호출 수를 줄이는 것 말고도, 여러 구간을 한 번의 호출에 묶어 보내거나 프로세스를 매번 새로 띄우지 않는 방식도 있습니다. 제 경우는 청크 수를 동시 실행 수에 맞추는 것만으로 52%가 줄어서 거기서 멈췄습니다.
고정비 68초는 제 환경에서 잰 값이라, CLI 종류나 시스템 프롬프트 길이, 맥락 크기가 다르면 달라집니다.
자주 묻는 질문
LLM 호출을 잘게 쪼개 병렬로 돌리면 항상 빨라지나요?
아닙니다. 호출당 고정비용이 실제 생성 시간보다 크면, 쪼갤수록 고정비를 더 내게 됩니다. 병렬화는 그 손해를 상쇄할 뿐이라 기대만큼 줄지 않습니다. 분할 전에 호출 1회의 고정비부터 재는 것이 먼저입니다.
LLM 호출의 고정비용은 어떻게 측정하나요?
호출 직전과 직후에 타임스탬프를 찍어 총 소요를 재고, 실제 생성에 걸린 시간과의 차이를 봅니다. 이 차이가 CLI 기동, 시스템 프롬프트·맥락 처리 같은 고정비입니다. 제 경우 호출당 약 68초였고 구간당 실제 생성은 약 1.9초뿐이었습니다.
고정비가 지배적일 때 병렬화는 어떻게 설계해야 하나요?
분할 수를 늘리는 대신 청크 수를 동시 실행 수에 맞춰 한 물결로 처리하는 방식이 유리합니다. 이 단계는 CPU 사용률이 5% 수준이라 동시에 여러 개를 띄워도 서버 부하가 사실상 없었기에, 물결 수를 줄이는 방향이 그대로 시간 단축으로 이어졌습니다.
병렬화가 최적화가 아니라 비용이 되는 경우는 언제인가요?
작업 단위당 고정비가 실제 처리 시간보다 클 때입니다. 이때 분할은 병렬로 감출 수 없는 고정비를 인원수만큼 늘리는 행위가 됩니다. 지배적인 비용이 고정비인지 처리량인지부터 계측해야 방향을 정할 수 있습니다.