PostgreSQL 백업 복구 리허설, 운영 DB 대신 임시 DB에 pg_restore 하기
Backblaze B2에 올려둔 암호화 덤프를 내려받아 임시 데이터베이스에 복원하고 운영 DB와 행 수를 대조하는 절차입니다. 단계별 명령어와 안 될 때 확인할 곳, 18MB 덤프로 해본 시간을 같이 적었습니다.
2026년 7월 19일에 집 서버의 PostgreSQL 백업을 처음으로 되돌려 봤습니다. Backblaze B2에서 암호화된 덤프를 내려받아 풀고, 운영 DB 옆에 임시 데이터베이스를 하나 만들어 복원한 뒤 행 수를 대조했습니다. 18MB 덤프 기준으로 내려받기부터 복원까지 10초 정도 걸렸고, 테이블 62개가 전부 돌아왔습니다. 운영 DB에는 한 번도 손대지 않았습니다.
이 글은 그때 쓴 명령어를 순서대로 적은 것입니다. 단계마다 안 될 때 어디를 보면 되는지도 같이 적었습니다.
백업이 매일 돌아도 복원은 따로 확인해야 하는 이유
그 전 주에 한 달 동안 조용히 안 돌던 백업을 겪고 heartbeat를 붙였습니다. 그 뒤로는 백업이 매일 돈다는 건 알림으로 확인하고 있었습니다.
그런데 파일이 매일 쌓여도 그 파일로 DB를 살려 본 적이 없으면 복원이 되는지는 모릅니다. 암호화 키가 틀렸을 수도 있고, 덤프가 깨졌을 수도 있고, 복원 순서를 몰라서 장애가 난 날 문서부터 찾고 있을 수도 있습니다. 해 보니 10초면 끝나는 확인이었는데 몇 주를 미뤄 두고 있었습니다.
해 보고 나서는 백업 알림을 볼 때 드는 생각이 달라졌습니다. 전에는 돌았다니 다행이라고 생각했고, 지금은 저 파일로 DB가 살아나는 걸 봤다고 생각합니다.
운영 DB 대신 임시 DB에 복원하는 이유
복구 문서를 보면 pg_restore --clean 처럼 기존 객체를 지우고 다시 만드는 명령이 자주 나옵니다. 리허설에서 이걸 운영 DB를 대상으로 그대로 치면 운영 데이터가 위험해집니다.
그래서 원칙을 하나로 정했습니다. 임시 DB를 새로 만들어 거기에 복원하고, 확인이 끝나면 지웁니다. 같은 PostgreSQL 컨테이너 안이어도 데이터베이스가 다르면 운영 데이터와 섞이지 않습니다.
백업 구성과 복구 순서
백업은 중고 맥미니로 꾸린 회사 서버의 PostgreSQL 컨테이너에서 pg_dump → openssl 암호화 → Backblaze B2 업로드 순서로 매일 새벽 3시에 돕니다. 복구는 이걸 거꾸로 밟습니다.
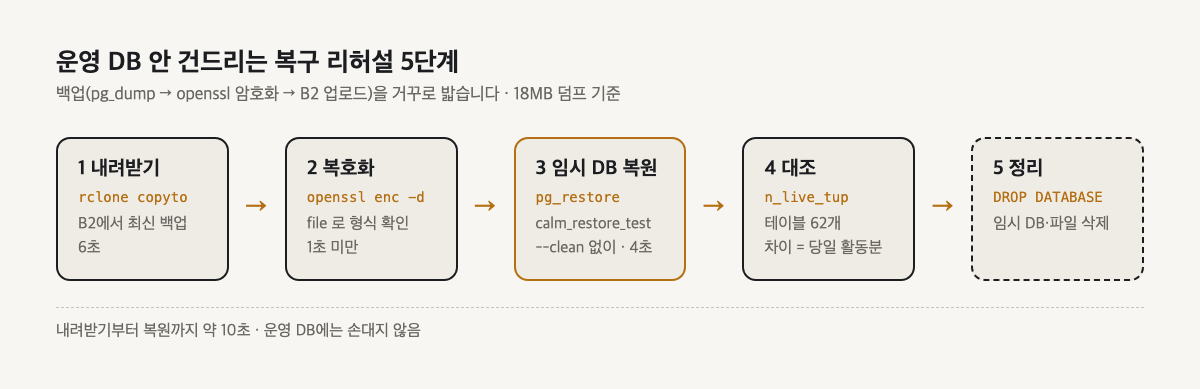
| 단계 | 하는 일 | 걸린 시간 |
|---|---|---|
| 1 | B2에서 최신 백업 내려받기 | 6초 |
| 2 | openssl 복호화 | 1초 미만 |
| 3 | 임시 DB에 pg_restore | 4초 |
| 4~5 | 운영 DB와 대조, 정리 | 따로 재지 않음 |
덤프 크기는 암호화한 상태로 18MB입니다.
1. rclone으로 B2에서 최신 백업 내려받기
rclone은 설정 파일 없이 환경변수만으로 B2에 연결할 수 있습니다.
export RCLONE_CONFIG_B2_TYPE=b2
export RCLONE_CONFIG_B2_ACCOUNT="$B2_KEY_ID"
export RCLONE_CONFIG_B2_KEY="$B2_APP_KEY"

rclone copyto \
  "b2:$B2_BUCKET/postgres/calm-core-calm_dev-20260719-030000.dump.enc" \
  ~/restore-test/latest.dump.enc
안 될 때는 먼저 rclone ls "b2:$B2_BUCKET/postgres/" 로 파일 목록이 보이는지 확인합니다. 목록조차 안 나오면 키 ID나 애플리케이션 키, 버킷 이름 쪽 문제이고, 목록은 나오는데 받기가 실패하면 파일 이름이 틀린 경우입니다.
2. openssl로 덤프 복호화하기
백업할 때 쓴 것과 같은 파라미터로 풀어야 합니다. 키는 명령 인자로 넘기지 않고 파일 디스크립터로 넘겨서 셸 히스토리나 프로세스 목록에 남지 않게 했습니다.
openssl enc -d -aes-256-cbc -md sha512 -pbkdf2 -iter 200000 \
  -in ~/restore-test/latest.dump.enc \
  -out ~/restore-test/restore.dump \
  -pass fd:3 3<<<"$BACKUP_ENCRYPTION_KEY"

file ~/restore-test/restore.dump
# PostgreSQL custom database dump - v1.15-0
풀고 나면 file 명령으로 덤프 형식이 맞는지부터 봅니다. 여기서 PostgreSQL custom database dump 가 안 나오면 키가 틀렸거나 -md, -iter 같은 파라미터가 백업 때와 다른 것입니다. openssl이 bad decrypt 를 내고 끝나는 경우도 같은 원인입니다.
3. 임시 DB를 만들고 pg_restore 하기
docker exec -e PGPASSWORD="$DB_PASSWORD" calm-prod-postgres \
  psql -U postgres -c "CREATE DATABASE calm_restore_test"

docker exec -i -e PGPASSWORD="$DB_PASSWORD" calm-prod-postgres \
  pg_restore -U postgres -d calm_restore_test \
  --no-owner --no-privileges < ~/restore-test/restore.dump
--clean 은 쓰지 않고, 방금 만든 빈 임시 DB에만 복원합니다. --no-owner --no-privileges 를 붙이면 덤프에 적힌 소유자와 권한을 그대로 재현하지 않아서, 복원하는 쪽에 같은 이름의 역할이 없어도 소유자 관련 에러가 나지 않습니다.
pg_restore가 에러를 내면 메시지 첫 줄부터 봅니다. 덤프를 만든 pg_dump보다 pg_restore 버전이 낮으면 덤프를 읽지 못하므로, 복원은 같은 버전이나 더 높은 버전의 PostgreSQL에서 해야 합니다.
4. 운영 DB와 행 수 대조하기
테이블 수와 큰 테이블 몇 개의 행 수를 두 DB에서 나란히 뽑습니다.
for db in calm_restore_test calm_dev; do
  docker exec -e PGPASSWORD="$DB_PASSWORD" calm-prod-postgres \
    psql -U postgres -d $db -t -A -c \
    "SELECT relname || '=' || n_live_tup
     FROM pg_stat_user_tables
     ORDER BY n_live_tup DESC LIMIT 6"
done
결과는 이랬습니다.
| 테이블 | 복원본 (03:00 스냅샷) | 운영 (당일 오후) |
|---|---|---|
| research_items | 8,154 | 8,366 |
| rate_limits | 6,080 | 6,080 |
| llm_jobs | 5,158 | 5,434 |
두 DB 모두 테이블은 62개였습니다. 행 수 차이는 전부 새벽 3시 백업 이후 그날 쌓인 데이터였습니다. 숫자가 다른 이유가 백업이 깨져서가 아니라 시점이 달라서로 설명되면 통과입니다. 반대로 복원본이 운영 쪽보다 크게 적어서 하루 동안 생길 수 없는 만큼 차이가 나면 덤프를 다시 의심해야 합니다.
n_live_tup 은 통계에서 가져오는 추정값이라 정확한 개수가 아닐 수 있습니다. 숫자가 애매하게 맞지 않으면 그 테이블만 SELECT count(*) 로 다시 세어 보면 됩니다.
5. 임시 DB와 내려받은 파일 지우기
docker exec -e PGPASSWORD="$DB_PASSWORD" calm-prod-postgres \
  psql -U postgres -c "DROP DATABASE calm_restore_test"
rm -rf ~/restore-test
임시 DB와 내려받은 파일을 지우면 서버는 리허설 전과 같은 상태로 돌아갑니다. 복호화한 restore.dump 는 암호화되지 않은 원본이라 남겨 두지 않는 편이 안전합니다.
DB가 커지면 달라지는 것
18MB라서 10초였고, 수십 GB면 내려받기와 복원에 시간이 꽤 걸립니다. 그때는 복구에 몇 분이 걸리는지 자체가 리허설을 해 봐야 알 수 있는 숫자가 됩니다. 예를 들어 복원에 40분이 걸린다는 걸 장애가 나기 전에 아는 것과 모르는 것은 대응이 많이 다릅니다. 임시 DB를 운영 DB 옆에 만드는 방식이라 복원하는 동안은 디스크 공간도 그만큼 더 필요합니다.
리허설 주기는 백업 구성이 바뀔 때마다 한 번, 그리고 분기에 한 번으로 잡았습니다. 다음 리허설 때는 이 다섯 단계를 스크립트 하나로 묶어서 명령 한 번에 끝나게 할 생각입니다.
자주 묻는 질문
백업 복구 테스트를 왜 운영 DB에 하면 안 되나요?
복구 명령은 기존 데이터를 덮어쓰는 옵션과 함께 쓰이는 경우가 많아, 실수 한 번이 운영 데이터 손실로 이어질 수 있습니다. 같은 서버라도 임시 데이터베이스를 새로 만들어 거기에 복원하면, 운영 데이터에 전혀 손대지 않고 백업이 살아나는지 확인할 수 있습니다.
복구 리허설은 얼마나 자주 해야 하나요?
백업 구성이 바뀌었을 때(암호화 방식, 저장소, 스크립트 수정)와 분기에 한 번 정도가 현실적인 기준입니다. 매일 할 필요는 없지만, 한 번도 안 해봤다면 백업이 실제로 복원 가능한지 아무도 모르는 상태입니다.
복원한 DB와 운영 DB의 행 수가 다르면 실패인가요?
아닙니다. 백업은 특정 시점의 스냅샷이므로, 그 이후에 쌓인 데이터만큼 운영 DB가 더 많은 것이 정상입니다. 차이가 백업 시각 이후의 활동량과 맞아떨어지는지 확인하면 오히려 검증이 더 정확해집니다.