자동 백업이 한 달 동안 안 돈 걸 몰랐던 이유와 heartbeat 감시 붙이기
에러 알림만 걸어 둔 자동화는 스크립트가 아예 실행되지 않으면 아무 신호도 보내지 않습니다. 백업이 지금 도는지 확인하는 순서와, 성공 신호가 끊기면 알리는 heartbeat를 직접 만들거나 Healthchecks.io로 붙이는 방법을 적었습니다.
로컬 데이터베이스를 실수로 날릴 뻔한 날, 백업이 제대로 쌓이고 있는지 처음으로 확인하러 갔습니다. 매일 새벽에 돌도록 등록해 둔 백업이 한 달 넘게 한 번도 실행되지 않은 상태였고, 에러 로그도 알림도 없었습니다. 서버를 다시 구성하면서 스크립트 안의 절대 경로 하나가 없는 경로가 된 게 원인이었습니다. 지금은 작업이 성공할 때마다 신호를 남기고, 그 신호가 하루(1440분)에 여유를 더한 시간을 넘겨 안 오면 텔레그램으로 알리는 heartbeat 감시를 붙여 두었습니다.
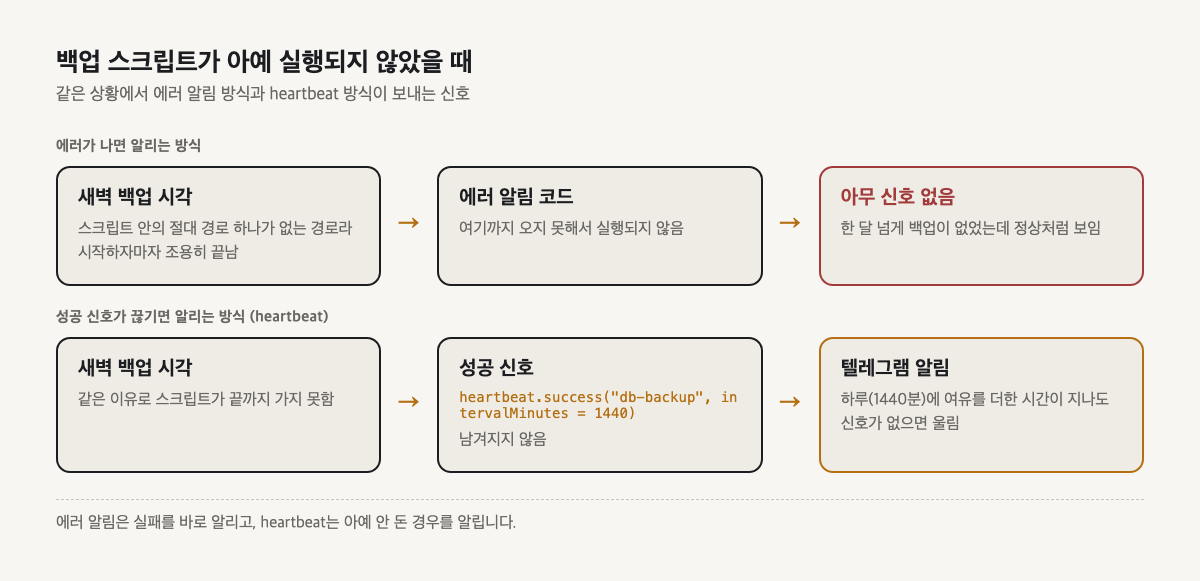
자동 백업이 실패해도 알림이 안 오는 이유
원인을 찾는 데는 오래 걸리지 않았습니다. 서버를 한 번 재구성하면서 스케줄 설정을 옮겼는데, 스크립트 파일도 있고 스케줄 항목도 있었지만 스크립트 안에서 참조하는 절대 경로 하나가 새 환경에는 없었습니다. 그래서 스크립트는 시작하자마자 조용히 끝났습니다.
설정 실수보다 더 문제였던 건 알림 구조였습니다. 제가 만든 자동화는 실패했을 때 알려주는 방식이었는데, 스크립트가 아예 끝까지 가지 못하면 실패를 알리는 코드도 실행되지 않습니다. 그러면 아무 신호도 오지 않고, 아무 신호가 없는 상태는 잘 돌고 있는 상태와 똑같아 보입니다. 이 구조라면 한 달이 아니라 1년이 지나도 모를 수 있습니다.
혼자 운영하면 이 상태를 대신 봐 주는 사람이 없습니다. 이번에 백업이 없다는 걸 안 건 감시 장치가 아니라 데이터를 날릴 뻔한 일 덕분이었습니다.
백업이 지금 실제로 돌고 있는지 확인하는 순서
알림을 붙이기 전에, 지금 상태부터 손으로 확인합니다. 위에서부터 보면 됩니다.
- 저장소에 올라간 마지막 백업 파일의 날짜. 백업이 실제로 남긴 결과물이라 가장 믿을 만합니다. 파일 이름에 날짜와 시각을 넣어 두면(예:
...-20260719-030000.dump.enc) 목록만 봐도 마지막으로 성공한 날이 보입니다. - 로그 파일의 마지막 수정 시각. 백업이 끝날 때 시각을 찍는 로그가 있다면, 그 시각이 어제 새벽인지 봅니다.
- 스케줄러에 등록돼 있는지와 마지막 실행 결과. cron이면
crontab -l로 항목이 있는지, macOS launchd면launchctl list | grep <작업 이름>으로 등록 여부와 마지막 종료 코드를 봅니다. - 스케줄러와 같은 조건으로 한 번 직접 실행. 터미널에서 내가 직접 돌리면 되는데 스케줄러에서만 안 되는 경우가 많습니다. 작업 폴더와 환경변수가 다르기 때문이라, 절대 경로로 실행해 보고 스크립트가 참조하는 경로가 전부 있는지 확인합니다.
1번 날짜가 오래됐다면 2~4번에서 어디서 멈췄는지 찾으면 됩니다.
경로 하나가 바뀌면 스크립트가 조용히 끝나는 이유
스케줄러로 돌리는 스크립트는 터미널에서 실행할 때와 환경이 다릅니다. cron은 아주 적은 환경변수만 가지고 실행되고, 출력도 따로 받아 두지 않으면 어디에도 남지 않습니다. 그래서 경로가 틀려 첫 줄에서 끝나도 화면에 뜨는 것도, 메일로 오는 것도 없습니다.
스크립트 앞부분에서 필요한 경로가 있는지 검사하고, 없으면 실패 알림을 보내게 고치는 것도 도움이 됩니다. 다만 이건 스크립트가 시작은 했을 때만 효과가 있습니다. 스케줄 항목이 빠졌거나 스케줄러 자체가 안 돌면 이 검사도 실행되지 않습니다. 그래서 바깥에서 “성공 신호가 왔는가”를 따로 봐야 합니다.
heartbeat 감시: 성공 신호가 끊기면 알리기
방식을 이렇게 바꿨습니다. 실패했을 때 알리는 대신, 성공했을 때 신호를 남기고 그 신호가 끊기면 이상으로 판단합니다.
외부 서비스를 붙일 수도 있었지만, 시스템 안에 이미 잡 실행 기록과 텔레그램 알림 채널이 있었습니다. 그래서 새 의존을 늘리지 않고, 각 정기 작업이 성공할 때마다 “마지막 성공 시각”을 남기고 그 시각이 자기 실행 주기를 넘겨 멈춰 있으면 알림을 보내는 기록 장치를 직접 붙였습니다. 작업이 성공으로 끝나는 자리에서 신호를 한 번 남기는 게 전부이고, 개념적으로는 이런 한 줄입니다.
// 정기 작업이 성공으로 끝나는 자리에서
heartbeat.success("db-backup", intervalMinutes = 1440)  // 하루 주기
db-backup 잡은 하루(1440분) 주기인데, 그만큼 지나도록 다음 성공 신호가 안 오면 감시 쪽이 이 잡이 멈췄다고 보고 알림을 보냅니다. 스크립트가 아예 실행되지 않아도 “신호 없음” 자체가 잡힙니다.
판정 시간에는 여유를 둡니다. 하루 한 번 도는 작업을 정확히 24시간에 걸면 잠깐 늦어지기만 해도 알림이 울리기 때문에, 주기보다 조금 넉넉하게 잡아서 한 번 건너뛴 게 확실할 때만 울리게 합니다.
직접 만들기와 Healthchecks.io 비교
같은 일을 해 주는 외부 서비스로 Healthchecks.io가 있습니다. 작업마다 고유 주소를 하나 받고, 작업이 끝날 때 그 주소로 요청을 보내면 됩니다. 정해 둔 간격(Period)에 여유 시간(Grace Time)을 더한 만큼 요청이 안 오면 알림이 갑니다.
| 항목 | 직접 만들기 | Healthchecks.io |
|---|---|---|
| 비용 | 없음 (기존 서버 사용) | 무료 플랜 $0, 작업 20개까지 |
| 기록 | 내가 정한 만큼 | 작업당 로그 100개 |
| 알림 | 이미 쓰는 채널 (텔레그램) | 서비스에서 연결 |
| 감시 위치 | 같은 시스템 안 | 내 서버 밖 |
무료 플랜 내용은 2026년 10월 요금 페이지에서 확인한 값입니다. 신호 보내는 주소 형식은 Pinging API 문서에 있고, 백업 스크립트 뒤에 붙이면 이런 모양이 됩니다.
# 성공했을 때만 신호
/path/to/backup.sh && curl -fsS -m 10 https://hc-ping.com/<uuid>

# 종료 코드를 그대로 보내기 (0이면 성공, 그 외는 실패로 처리)
/path/to/backup.sh; curl -fsS -m 10 https://hc-ping.com/<uuid>/$?
종료 코드를 보내는 방식은 실패를 바로 알리고, 아예 안 돈 경우는 간격과 여유 시간이 지나서 알립니다. 에러 알림과 heartbeat를 한 줄로 같이 거는 셈입니다.
heartbeat로 못 잡는 것
heartbeat는 “성공 신호가 왔는가”만 봅니다. 그래서 아래 경우는 따로 봐야 합니다.
- 신호를 너무 일찍 보내는 경우. 덤프만 만들고 업로드 전에 신호를 보내면, 업로드가 실패해도 성공으로 기록됩니다. 신호는 마지막 단계가 끝난 뒤에 보냅니다.
- 백업 파일이 있는데 복원이 안 되는 경우. 파일이 매일 쌓이는 것과 그 파일로 데이터가 살아나는 것은 다른 문제입니다. 운영 DB를 건드리지 않고 임시 DB에 복원해 본 절차는 백업 복구 리허설 글에 적었습니다.
- 감시하는 쪽이 같이 죽는 경우. 직접 만든 감시가 백업과 같은 서버에 있으면, 서버가 통째로 멈췄을 때 알림도 같이 안 옵니다. 이 경우는 Healthchecks.io처럼 서버 밖에 있는 서비스가 있어야 잡힙니다.
- 실행은 됐는데 결과물이 안 나오는 경우. 작업은 매번 돌았지만 만료된 토큰 때문에 결과물이 안 올라간 일은 만료된 토큰 글에 따로 적었습니다.
지금은 비슷한 방식으로 돌던 다른 자동화들도 하나씩 다시 보고 있습니다. 에러가 나면 알림이 오는 작업인지, 살아 있다는 신호가 와야 정상인 작업인지를 나눠서 두 번째에 heartbeat를 붙이는 중입니다.
자주 묻는 질문
자동 백업이 실패해도 알림이 안 오는 이유가 뭔가요?
대부분의 자동화 스크립트는 에러가 발생했을 때만 알림을 보내도록 설계되어 있습니다. 그런데 스크립트 자체가 실행되지 않으면 에러도 발생하지 않아 아무 신호도 오지 않습니다. cron 데몬이 죽거나, 스케줄 설정이 잘못되거나, 실행 경로가 바뀐 경우가 대표적입니다.
heartbeat 모니터링이란 무엇인가요?
작업이 성공적으로 완료되었을 때 "살아있다"는 신호를 남기는 방식입니다. 정해진 주기 안에 신호가 오지 않으면 이상이 생긴 것으로 판단해 알림을 보냅니다. 성공을 감시하는 구조이기 때문에, 스크립트가 아예 실행되지 않아도 탐지할 수 있습니다.
heartbeat는 외부 서비스를 써야 하나요, 직접 만들어야 하나요?
둘 다 가능합니다. Healthchecks.io 같은 외부 서비스는 붙이기 쉽고 무료 플랜도 있습니다. 저는 이미 잡 실행 기록과 텔레그램 알림 채널을 시스템 안에 갖고 있어서, 각 잡의 마지막 성공 시각을 기록하고 주기를 넘겨 침묵하면 경보하는 방식을 직접 붙였습니다. 새 의존을 늘리지 않는 쪽을 택한 것입니다.
백업 스크립트가 실제로 돌았는지 확인하는 가장 간단한 방법은 뭔가요?
백업 완료 후 타임스탬프가 찍힌 로그를 남기고 그 최종 수정 시각을 주기적으로 확인하는 것이 가장 단순합니다. 더 나아가 성공할 때마다 어딘가에 신호를 남기고, 그 신호가 끊기면 알림이 오도록 만들면 자동으로 감시됩니다.
1인 개발자에게 백업 검증이 특히 중요한 이유가 있나요?
팀이 있으면 누군가 백업 상태를 주기적으로 확인하거나 공유 모니터링을 보는 문화가 생깁니다. 1인 개발자는 백업이 잘 돌겠지 하고 믿어버리면 아무도 확인하지 않는 상태가 지속됩니다. 문제를 발견했을 때는 이미 복구가 필요한 시점인 경우가 많습니다.