cron과 claude -p로 급하지 않은 AI 작업을 새벽 2~5시에 처리하는 워커
낮에 쌓인 요약·리포트 작업을 cron이 새벽 2시에 깨운 Node 워커가 5시까지 한 건씩 처리합니다. 래퍼 스크립트와 루프 코드, 워커가 안 돌 때 확인할 곳을 정리했습니다.
AI에 맡기는 일 중 결과가 바로 필요 없는 것들은 들어오는 대로 처리하지 않고 큐에 모아 둡니다. 집에 있는 맥미니 서버에서 cron이 새벽 2시에 Node 워커를 깨우면, 워커는 5시까지 큐에서 한 건씩 꺼내 claude -p로 처리하고 스스로 꺼집니다. 건마다 20~90초씩 쉬고, 인증은 API 키가 아니라 그 서버에 로그인해 둔 구독 세션을 씁니다. 아침에는 결과만 확인합니다.
이 글에는 cron 한 줄, 시간창을 넘겨주는 래퍼 스크립트, 워커 루프 코드, 그리고 워커가 안 돌 때 어디부터 보면 되는지를 순서대로 적었습니다.
어떤 AI 작업을 새벽으로 미루나
기준은 “오늘 안에 결과를 안 봐도 되는가”입니다. 수집한 글 요약, 분류, 주간 리포트, 아침 브리핑, 콘텐츠 초안 같은 일이 여기에 들어갑니다. 오늘 모은 글의 요약은 내일 아침에 봐도 되고, 주간 리포트는 주말 아침에 나와 있으면 됩니다.
반대로 사람이 화면 앞에서 기다리는 요청은 미루지 않습니다. 그런 건 종량제 API로 바로 처리하고 비용도 따로 봅니다. 새벽 워커는 미뤄도 되는 무거운 일만 맡습니다.
전체 구조: 큐, cron, 시간창 워커
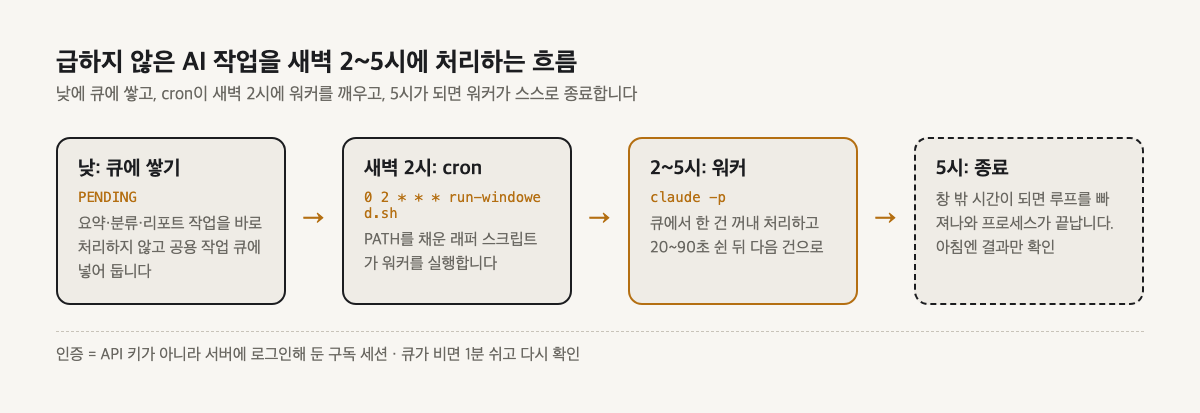
흐름은 세 단계입니다.
- 낮: 큐에 쌓기. 수집기나 다른 작업이 분석할 거리를 만들 때마다, 바로 처리하지 않고 공용 작업 큐에
PENDING으로 넣어 둡니다. - 새벽 2시: cron이 워커를 깨웁니다.
- 2~5시: 시간창 안에서만 처리합니다. 워커는 큐에서 하나씩 꺼내 처리하고, 매 건 사이에 무작위로 쉬었다가, 창 밖 시간이 되면 스스로 종료합니다.
낮에 쌓인 일이 자는 동안 처리되고, 아침엔 결과만 받습니다.
워커가 작업 하나를 처리하는 순서
워커는 worker.mjs 파일 하나로 되어 있고 외부 패키지 없이 Node에 들어 있는 fetch만 씁니다. 로그인 응답의 쿠키를 읽는 데 headers.getSetCookie()를 쓰기 때문에 Node 18 이상이 필요하고, 22 이상을 권장합니다.
작업 하나는 이렇게 지나갑니다.
- 백엔드에 로그인해서 인증 쿠키를 받습니다.
- 큐에서
PENDING상태인 작업을 가져옵니다. - 작업에 들어 있는 프롬프트로
claude -p <prompt> --output-format text를 실행합니다. - 나온 글을 결과로 돌려보내고, 실패하면 실패로 표시합니다.
- 중간에 로그인이 만료되면(401) 다시 로그인합니다.
워커는 Docker 컨테이너가 아니라 서버에서 직접 도는 Node 프로세스입니다. claude 명령을 직접 실행해야 해서, claude가 설치되고 로그인된 그 컴퓨터에서 돌아야 합니다.
cron으로 새벽 2시에 워커 깨우기
0 2 * * * /bin/bash ~/llm-worker/scripts/run-windowed.sh >> ~/llm-worker/llm-worker.log 2>&1매일 새벽 2시에 워커 스크립트를 실행하고 로그를 파일에 남깁니다. 로그를 파일로 빼 두지 않으면 cron에서 실패해도 남는 게 없습니다.
여기서 먼저 걸리는 게 cron의 PATH입니다. cron은 로그인 셸과 달리 PATH가 거의 비어 있어서, 터미널에서는 잘 되던 node나 claude를 못 찾고 조용히 실패합니다. 그래서 스크립트 맨 위에서 PATH를 직접 채워 줍니다. SSH로 명령을 바로 보낼 때 command not found가 나는 것도 비슷한 이유인데, 그 경우는 SSH로 명령을 던지면 command not found가 나는 이유에 따로 정리했습니다.
시간창 래퍼 스크립트
#!/usr/bin/env bash
set -euo pipefail

# cron은 PATH가 최소라 node·claude를 못 찾는다 → 보강
export PATH="/usr/local/bin:/opt/homebrew/bin:$HOME/.local/bin:$PATH"

cd "$(dirname "$0")/.."

EXIT_WHEN_OUT_OF_WINDOW=true \
PROCESS_WINDOW_START_HOUR=2 \
PROCESS_WINDOW_END_HOUR=5 \
node --env-file=.env worker.mjs
처리 시간창(2~5시)과 “창 밖이면 종료” 옵션을 환경 변수로 넘기고, 실제 처리는 worker.mjs가 합니다. 백엔드 주소와 로그인 계정은 node --env-file=.env로 .env 파일에서 읽습니다. 이 파일에는 비밀번호가 들어가니 저장소에 커밋하지 않고 .gitignore에 넣어 둡니다.
인증은 API 키가 아니라 구독 세션을 그대로 씁니다. 그래서 토큰당 요금이 따로 나가지 않고 구독 한도 안에서 돌아갑니다.
워커 루프: 시간창 안에서 한 건씩
핵심 로직만 추리면 이렇게 생겼습니다.
const START = Number(process.env.PROCESS_WINDOW_START_HOUR); // 2
const END = Number(process.env.PROCESS_WINDOW_END_HOUR);     // 5

const inWindow = () => {
  const h = new Date().getHours();
  return h >= START && h < END;
};

const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

while (inWindow()) {
  const job = await claimNextPendingJob();    // 큐에서 하나 꺼내기
  if (!job) { await sleep(60_000); continue }  // 없으면 잠깐 쉬고 재확인

  await process(job);                           // 구독 세션으로 처리

  // 건당 20~90초 간격을 두고 다음 작업
  await sleep((20 + Math.random() * 70) * 1000);
}

// 창 밖이면 루프 종료 → 프로세스 exitinWindow가 처리 시간을 새벽 25시로 묶고, 90초 사이의 간격을 둡니다. 큐가 비어 있으면 1분 쉬고 다시 확인합니다. 시계가 5시를 넘기면 sleep이 건마다 20while 조건이 거짓이 되어 루프를 빠져나오고 프로세스가 끝나니, 다음 날 새벽 2시에 cron이 다시 깨울 때까지는 아무것도 돌지 않습니다.
처리량은 이 두 숫자로 조절합니다. 2026년 6월 말 서버에서 확인했을 때는 하룻밤에 4585건을 처리했고, 수집은 하루 67건 안팎이라 큐에 12일 치가 밀려 있었습니다. 이렇게 밤사이 큐가 다 안 비면 창을 2~6시로 늘리거나 간격을 줄입니다.
claude -p를 구독 로그인으로 쓸 때 확인할 것
claude -p는 Claude Code를 대화 화면 없이 한 번 실행하고 결과만 출력하는 옵션입니다. --output-format은 기본값이 text이고, json이나 stream-json으로 바꿀 수 있습니다(Claude Code 공식 문서: Run Claude Code programmatically, 2026년 10월 확인).
구독 로그인으로 돌릴 때는 세 가지를 먼저 봅니다.
- 워커가 도는 컴퓨터에서 로그인했는가. 개발용 맥에서 로그인해 둔 건 서버에 적용되지 않습니다. 서버에서
claude를 한 번 실행해 로그인을 끝내 둡니다. - cron 없이 단독으로 되는가. 서버에서
claude -p "hi"를 직접 쳐서 답이 오는지 봅니다. 이게 안 되면 워커 쪽은 볼 필요가 없습니다. --bare를 붙이지 않았는가. 공식 문서 기준으로--bare모드는 구독 로그인(OAuth)이나 키체인을 읽지 않고,ANTHROPIC_API_KEY를 따로 넣어야 돌아갑니다(2026년 10월 확인). 시작이 빨라진다고 붙이면 구독 세션을 못 씁니다.
워커가 안 돌 때 확인할 곳
대부분은 로그 파일(llm-worker.log)에 남은 한 줄로 원인이 갈립니다.
| 로그에 보이는 것 | 원인 | 확인할 것 |
|---|---|---|
... is required 후 바로 종료 | .env 필수값 누락 | 백엔드 주소·계정·비밀번호 |
cycle failed: HTTP 401 반복 | 계정 권한 문제 | 계정이 막혔는지 |
claude timed out after 120000ms | 응답이 2분을 넘김 | 프롬프트 크기·로그인 상태 |
claude returned empty output | 로그인 만료 또는 거부 | 서버에서 다시 로그인 |
pending=0 processed=0 반복 | 처리할 작업이 없음 | 정상. 큐에 작업이 생기는지 |
401은 워커가 알아서 다시 로그인하지만, 계정 자체가 막혀 있으면 같은 줄이 끝없이 반복됩니다. 로그 파일 자체가 비어 있으면 워커가 시작도 못 한 것이니 cron 등록과 PATH부터 봅니다. 이렇게 소리 없이 멈춘 자동화를 찾는 방법은 만료된 토큰이 닷새를 먹은 일에 따로 적었습니다.
이 방식이 맞는 작업과 안 맞는 작업
이 방식의 대가는 지연입니다. 낮에 들어온 분석은 그날 밤에야 처리되니, 빠르면 몇 시간, 큐가 밀린 때는 하루에서 이틀까지 늦습니다. 대신 종량제 API를 쓰지 않고 구독 한도 안에서만 돌기 때문에 운영비가 거의 들지 않습니다.
그래서 요약·분류·리포트처럼 하루 늦어도 괜찮은 일은 새벽으로 보내고, 사용자가 화면에서 기다리는 요청은 따로 바로 처리합니다.
자주 묻는 질문
실시간으로 바로 필요한 작업도 이렇게 미루나요?
아니요. 이 방식은 급하지 않은 배치 작업(요약·분류·리포트 생성)에만 씁니다. 사용자가 화면에서 기다리는 실시간 요청은 종량제 API로 즉시 처리하고, 비용이 들어도 그쪽은 따로 둡니다. 미뤄도 되는 무거운 작업만 새벽으로 몰아넣는 게 핵심입니다.
왜 하필 새벽 2~5시인가요?
제가 낮에 직접 AI를 쓰는 시간과 겹치지 않게 하려는 것입니다. 같은 계정을 쓰기 때문에 낮에 자동 작업이 돌면 제 작업이 밀립니다.
큐에 작업이 쌓이는 속도가 처리 속도보다 빠르면 어떻게 하나요?
시간창 길이와 건당 간격으로 처리량을 조절합니다. 유입이 더 많으면 창을 늘리거나(2~6시) 간격을 줄입니다. 그래도 약간의 지연은 남는데, 요약·분석은 하루 늦어도 괜찮은 작업이라 그 지연을 감수하는 설계입니다.