whisper.cpp -dtw 타임스탬프로 자막 싱크를 검증하면 안 되는 이유
whisper.cpp의 -dtw 옵션은 자막 분할 경계(t0/t1)를 바꾸지 않고, 원본 오디오와 대조하면 오히려 늦게 찍혔습니다. 자막 싱크를 잴 정답지를 원본 오디오에서 뽑는 방법과 -ml이 바이트 기준이라는 점까지 실측값으로 정리했습니다.
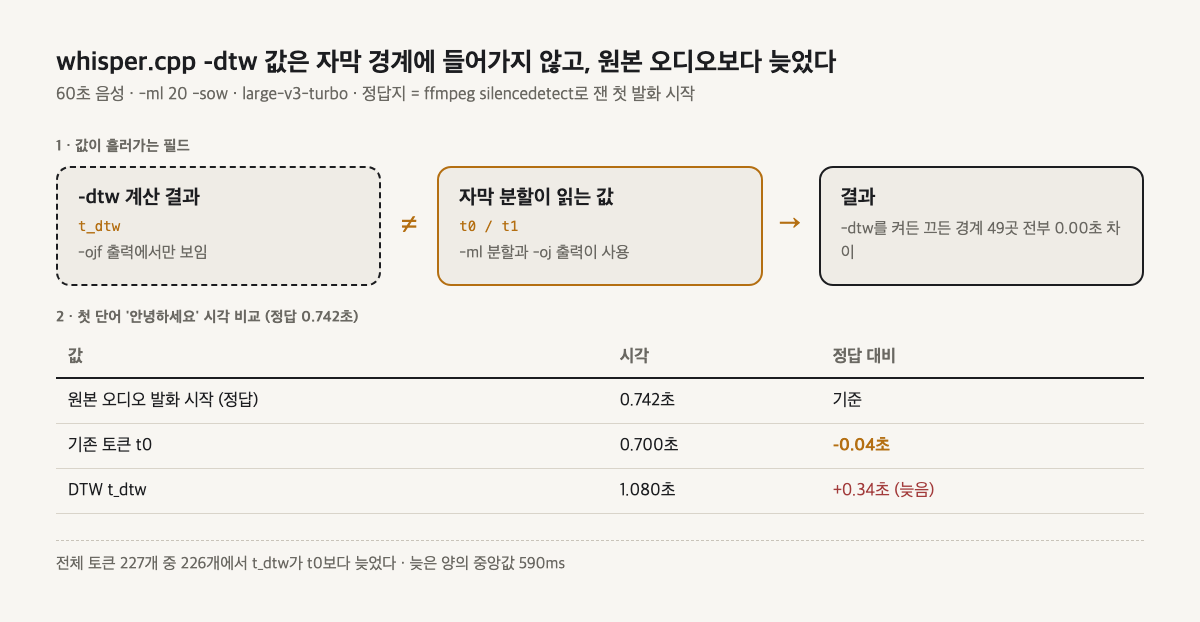
영상 렌더 파이프라인에서 자막 싱크가 맞는지 재려고, whisper.cpp의 -dtw(토큰 단위 정밀 타임스탬프) 값을 정답지로 쓰려 했습니다. 결과는 두 가지였습니다. -dtw를 켜도 자막 분할 경계는 49곳 전부 0.00초, 1ms도 바뀌지 않았고, DTW 값을 따로 꺼내 원본 오디오와 대조했더니 227개 토큰 중 226개에서 기존 값보다 늦게 찍혔습니다(중앙값 590ms). 자막 싱크의 정답지는 -dtw가 아니라 원본 오디오에서 직접 잰 발화 시각이어야 했습니다.
아래에 옵션이 실제로 무엇을 바꾸는지, 원본 오디오에서 정답 시각을 뽑는 명령어, 그리고 비슷한 실수를 피하려고 지금 확인하는 순서를 적었습니다.
whisper.cpp -dtw 옵션이 바꾸는 값과 안 바꾸는 값
whisper.cpp CLI 도움말에는 -dtw MODEL이 “compute token-level timestamps”라고만 적혀 있습니다(whisper.cpp CLI README). 이름만 보면 자막 타임스탬프 전체가 더 정확해질 것 같지만, 실제로 바뀌는 곳은 한 군데입니다.
-dtw로 계산한 값은 토큰마다 붙는t_dtw필드에만 들어갑니다.- 자막을 나누는
-ml분할과-ojJSON 출력이 쓰는 값은t0/t1이고, 여기에는 DTW 결과가 반영되지 않습니다. t_dtw를 보려면-ojf(더 많은 정보를 담은 JSON 출력)를 같이 켜야 합니다. 값은 센티초 단위의 절대 시각으로 나왔습니다.
정밀한 값을 계산하긴 하는데, 그 값이 들어가는 필드와 자막 분할이 읽는 필드가 서로 다릅니다.
-dtw를 켜도 자막 경계가 1ms도 안 바뀐 실측
60초짜리 음성 조각으로 같은 조건에서 두 번 받아쓰기를 돌렸습니다. 공통 인자는 -ml 20 -sow(단어 단위로 나누기), 모델은 large-v3-turbo, 언어는 -l ko였고, 한쪽에만 -dtw를 더했습니다.
로그에 dtw = 1이 찍혀서 옵션이 정상으로 돈 건 확인했습니다. 그런데도 두 결과를 비교하니 분할 경계 49곳이 전부 0.00초 차이였고 텍스트도 같았습니다.
처음에는 차이가 없으니 기존 -ml 타임스탬프가 정확하다고 결론을 낼 뻔했습니다. 49곳이 정확히 0.00이라는 결과가 너무 깔끔해서 다시 봤고, 그때 DTW 값이 다른 필드에만 들어간다는 걸 알았습니다. 그대로 결론을 냈다면 답은 맞았어도 근거는 틀렸을 겁니다.
자막 싱크 정답지를 원본 오디오에서 뽑는 방법
그래서 정답지를 도구 바깥에서 구했습니다. ffmpeg의 silencedetect 필터로 무음 구간을 찾으면, 무음이 끝나는 지점이 발화가 시작되는 시각입니다.
먼저 원본에서 16kHz 모노 WAV로 60초를 잘라냅니다.
ffmpeg -v error -y -t 60 -i voice.m4a -ar 16000 -ac 1 -c:a pcm_s16le /tmp/b.wav그다음 무음 구간을 찾습니다.
ffmpeg -i /tmp/b.wav -af silencedetect=noise=-32dB:d=0.15 -f null -여기서 한 번 막혔습니다. 처음에는 두 번째 명령에도 -v error를 붙였는데 무음이 0개로 나왔습니다. silencedetect 결과는 INFO 수준 로그로 찍혀서, -v error를 붙이면 통째로 안 보입니다. 무음이 없는 게 아니라 출력이 숨겨졌던 것이라, 이 명령은 기본 로그 수준으로 돌려야 합니다.
무음 구간과 자막 조각을 하나씩 짝지어 비교하는 방식은 쓸모가 없었습니다. 쉼은 138곳, 자막 카드는 116개처럼 개수부터 다르고, 자막은 쉼 없는 문장 중간에서도 끊기는 게 정상이기 때문입니다. 대신 첫 발화처럼 짝이 분명한 지점 하나는 확실한 기준이 됐습니다. 이 음성의 첫 발화는 0.742초에 시작했습니다.
DTW 타임스탬프가 휴리스틱보다 늦게 찍힌 결과
첫 단어 안녕하세요의 시각을 정답 0.742초와 나란히 놓았습니다.
| 값 | 시각 | 정답 대비 |
|---|---|---|
기존 토큰 t0 | 0.700초 | -0.04초 |
DTW t_dtw | 1.080초 | +0.34초 (늦음) |
정밀하다던 DTW가 340ms 늦었고, 기존 t0는 40ms 안쪽이었습니다. 한 단어만 그런지 보려고 전체 토큰을 비교하니 방향이 같았습니다. 227개 중 226개에서 t_dtw가 t0보다 늦었고, 늦은 양의 중앙값은 590ms였습니다. 우연한 오차가 아니라 한쪽으로 쏠린 차이입니다.
t_dtw는 토큰의 시작이 아니라 끝 쪽을 가리키는 값으로 보입니다. 어느 쪽이든 자막 카드가 뜨는 시각을 판단하는 기준으로는 쓸 수 없었습니다.
whisper -ml 최대 길이는 글자 수가 아니라 바이트 수
이 과정에서 하나 더 확인한 게 있습니다. 도움말에는 -ml이 “maximum segment length in characters”라고 적혀 있지만, 실제로는 바이트 수 기준으로 잘렸습니다.
UTF-8에서 한글 한 글자는 3바이트입니다. 그래서 -ml 값을 글자 수로 알고 잡으면 한글 자막은 예상한 길이의 3분의 1 지점에서 끊깁니다. 영어 자막에 맞춰 둔 값을 한국어에 그대로 쓰면 조각이 훨씬 잘게 나오는 이유입니다. -ml 20이면 한글은 6~7글자 안팎에서 나뉜다고 보면 됩니다.
자막 싱크가 어긋나 보인 진짜 원인
-ml 타임스탬프가 부정확하다는 가설은 이렇게 빠졌고, 남은 원인은 자막 카드 수였습니다. 자막을 읽기 쉽게 짧게 끊으면서 6분 19초 영상의 카드가 66개에서 116개로 늘었습니다. 오차 크기는 같아도 전환이 두 배 가까이 잦아지니 어긋남이 더 자주 눈에 띈 것입니다.
whisper가 원래 내놓는 구간은 20초 안팎의 긴 덩어리라, 자막 하나가 20초를 덮던 때는 어긋날 여지가 거의 없었습니다. 그래서 타임스탬프를 고치는 대신 카드 상한을 42자·4.5초에서 58자·8초로 늘렸습니다. 8분 13초 영상으로 확인해 보니 옛 상한이었다면 약 151개였을 카드가 110개로, 약 27% 줄었습니다. 이때 실제로 카드를 끊던 상한은 글자 수가 아니라 시간이었습니다. 한국어 발화는 초당 9자 정도라 4.5초 상한이면 42자에 닿기 전에 먼저 끊겼습니다.
첫 자막 하나만 0.56초 일찍 뜨는 현상도 따로 있었습니다. whisper의 첫 구간은 0.18초에서 시작하는데 실제 발화는 0.742초였기 때문입니다. 두 번째 구간부터는 구간 시작과 첫 토큰 시작이 같아서 문제가 없었고, 영향이 카드 하나뿐이라 그대로 뒀습니다.
같은 파이프라인에서 whisper 바이너리 버전 설정이 실제로 먹지 않던 문제는 whisper.cpp 버전 설정이 안 먹을 때에, 렌더 시간을 줄인 과정은 Remotion 렌더를 구간별 스틸로 바꾼 글에 적었습니다.
자막 싱크를 검증할 때 확인하는 순서
지금은 정답지로 쓸 값을 고를 때 아래 순서로 봅니다.
- 그 옵션이 내가 쓰는 필드를 바꾸는지 봅니다. 옵션을 켠 출력과 끈 출력을 비교해서, 쓰려는 필드(
t0/t1)가 실제로 달라지는지 확인합니다. - 결과가 지나치게 깔끔하면 다시 봅니다. 49곳이 전부 0.00초처럼 나오면 정확해서가 아니라 값이 아예 안 들어갔을 수 있습니다.
- 기준이 검증 대상과 다른 출처인지 봅니다. 같은 도구가 뽑은 다른 필드로는 그 도구의 오차를 찾기 어렵습니다. 자막이라면 원본 오디오가 바깥 기준입니다.
- 짝이 분명한 지점 하나로 먼저 잽니다. 첫 발화 시작처럼 정답이 하나로 정해지는 곳에서 오차 방향과 크기를 확인한 뒤 전체 토큰으로 넓힙니다.
- 로그 수준을 확인합니다. ffmpeg 분석 필터는
-v error로 돌리면 결과가 안 보입니다.
자주 묻는 질문
whisper의 -dtw 옵션을 켜면 자막 분할 경계가 더 정확해지나요?
제 실측에서는 아니었습니다. -dtw로 계산한 값은 t_dtw라는 별도 필드에만 들어가고, -ml 분할이 실제로 참조하는 t0/t1에는 반영되지 않았습니다. 그래서 분할 경계 49곳을 비교했을 때 옵션을 켜든 끄든 전부 0.00초, 1ms도 달라지지 않았습니다.
DTW 타임스탬프가 휴리스틱보다 정밀하다는데 왜 더 틀렸나요?
정밀하다는 것과 정답에 가깝다는 것은 다른 문제입니다. 실제 발화 시작 시각을 원본 오디오로 재보니, 휴리스틱 값이 오히려 정답에 가깝고 DTW 값은 전반적으로 늦게 찍혔습니다. 제 데이터에서는 227토큰 중 226개에서 DTW가 더 늦었고 중앙값이 590ms 차이였습니다.
whisper의 -ml(최대 길이) 옵션은 글자 수 기준인가요?
문자 수가 아니라 바이트 수 기준입니다. UTF-8에서 한글 한 글자는 3바이트라, -ml 값을 글자 수로 착각하면 한글 자막은 예상의 3분의 1 길이에서 잘립니다. 언어별로 체감 분할 위치가 크게 달라지는 이유입니다.
도구가 제공하는 정밀 모드를 정답지로 삼아도 되나요?
권하지 않습니다. 정밀 모드는 어디까지나 그 도구 내부의 추정치이고, 검증 대상과 검증 기준이 같은 출처면 오차를 발견할 수 없습니다. 정답지는 원본 오디오나 원 데이터처럼 도구 바깥의 사실이어야 합니다.